Kapitel 1
Ein erstes Modell
In diesem Kapitel wollen wir ein Programm entwickeln, das zwischen zwei Sorten von Punkten unterscheiden kann. Wir beginnen mit einem einzelnen Neuron und bauen dann aus Schichten von Neuronen ein kleines Netz, das seine Gewichte selbst findet.
Zwei Sorten von Punkten
Gegeben sei eine Ebene mit den Koordinaten
und , jeweils von -6 bis +6. In diese Ebene setzen
wir Punkte zweier Sorten: orange und blau. In den Programmen wird die
Sorte eines Punkts durch eine Zahl dargestellt: 1
für orange und -1 für blau.
Ein Modell ist eine Funktion, die aus den Koordinaten und eines Orts in dieser Ebene eine Vermutung über die Sorte eines Punkts an diesem Ort berechnet, einen Wert zwischen -1 und +1. Bei -1 ist sich das Modell sicher, dass dort ein blauer Punkt liegt, bei +1 sagt es mit Sicherheit einen orangen voraus. Werte dazwischen drücken Unsicherheit aus: Das Vorzeichen sagt, welche Sorte das Modell eher vermutet, und je näher der Wert an 0 liegt, desto unsicherer ist es; bei 0 kann es sich nicht entscheiden.
Eine solche Funktion könnten wir beliebig formulieren, etwa
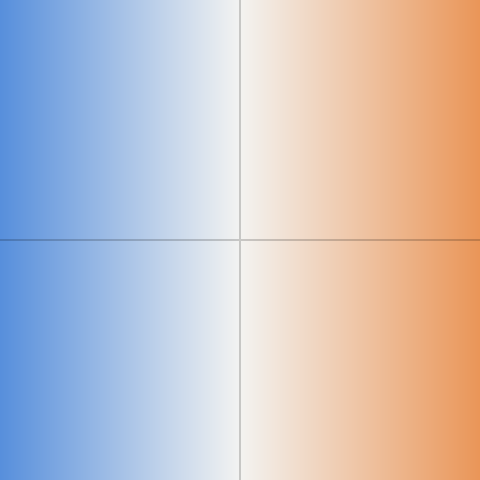
Sie ist am rechten Rand +1, am linken -1 und auf der senkrechten Achse 0: Rechts vermutet sie orange, links blau, und je näher zur Mitte, desto unsicherer ist sie. Oder
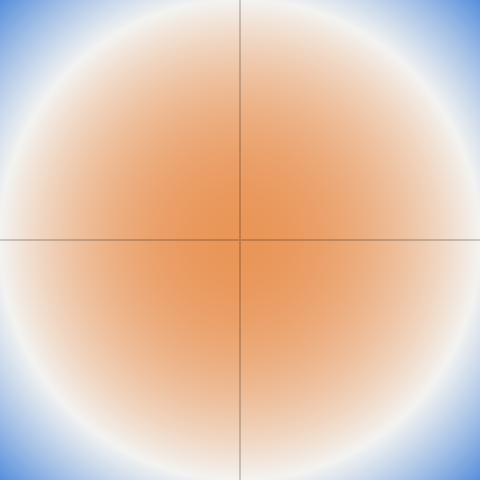
Sie ist im Mittelpunkt +1, in den vier Ecken −1, denn dort ist , und auf dem Kreis mit dem Radius 6 um den Mittelpunkt, wo ist, ist sie 0. Ob eine solche Funktion die Sorte der Punkte gut vorhersagen kann, hängt davon ab, wie sie liegen: Die erste passt zu Punkten, die rechts orange und links blau sind, die zweite zu einer orangen Scheibe in einem blauen Ring.
Maschinelles Lernen hingegen denkt sich die Formel nicht aus. Es legt nur ihre allgemeine Form fest, eine Formel mit offenen Zahlen, den Parametern. Im zweiten Beispiel könnte die 36 eine solche offene Zahl sein, , und gäbe an, wie groß die orange Scheibe ist; wo die Formel dabei unter −1 fällt, zählt sie als −1. Welche Werte die Parameter bekommen, findet ein Programm aus Beispielen heraus, aus Punkten, deren Sorte bekannt ist. Dieses Finden nennt dieses Buch Lernen, und eine Funktion mit gefundenen Parametern ein trainiertes Modell.
Ein Neuron
Die einfachste Form einer solchen Funktion ist ein Neuron. Es multipliziert jede seiner Eingaben mit einer eigenen Zahl, seinem Gewicht, zählt alles zusammen und addiert noch eine Zahl, seinen Bias:
Das Ergebnis heißt die gewichtete Summe des Neurons. Wo sie positiv ist, vermutet das Neuron orange, wo sie negativ ist, blau. Die Punkte, an denen genau 0 ist, bilden eine Gerade; ein Neuron teilt die Ebene also durch eine Gerade: Die Gewichte drehen sie, der Bias verschiebt sie.
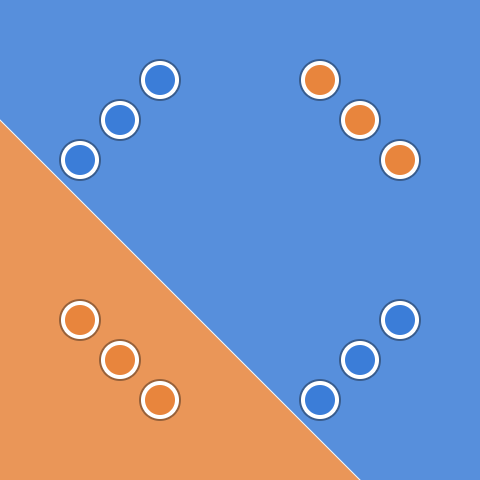
Nun wollen wir versuchen, das Neuron so anzupassen, dass es die Farbe von sechs Punkten, die wir willkürlich in der Ebene verteilen, möglichst gut bestimmen kann: drei orange und drei blaue. Wir beginnen mit den Gewichten 1 und 1 und dem Bias 0:
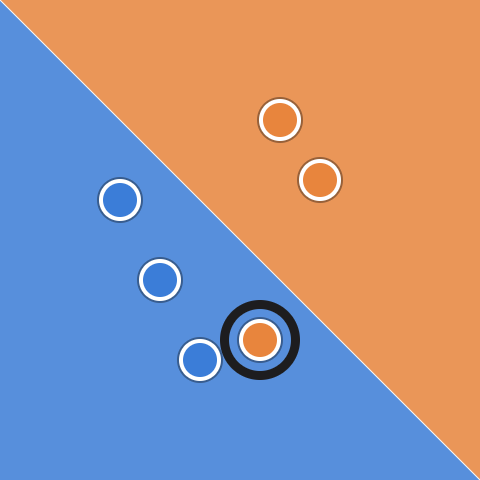
Fünf der sechs liegen auf der richtigen Seite; der eingekreiste ist orange, liegt aber unterhalb der Geraden. Mit dreht sich die Gerade zur senkrechten Achse, und alle sechs stimmen:
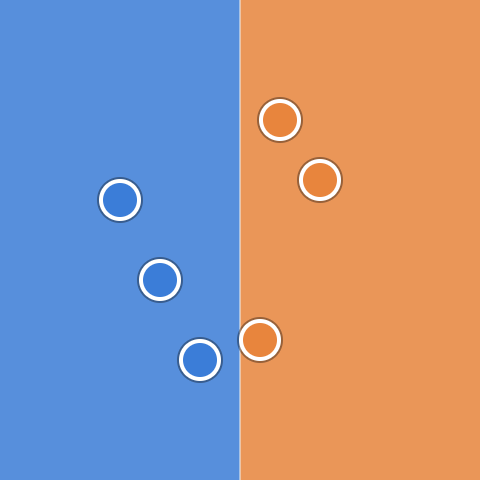
Die Gewichte und den Bias schrittweise zu verändern, bis die Vermutungen stimmen, ist das Wesen dessen, was wir als Lernen bezeichnen wollen.
Wie falsch
Um die Gewichte von selbst zu ändern, braucht ein Programm ein Maß dafür, wie falsch das Neuron liegt. Dieses Maß ist eine Zahl, die kleiner wird, wenn das Neuron besser wird. Die falschen Vermutungen zu zählen taugt dafür nicht: Eine kleine Änderung eines Gewichts ändert meist gar keine Vermutung, also sagt die Anzahl nicht, in welche Richtung zu drehen ist.
Deshalb bilden wir die gewichtete Summe zuerst mit einer glatten Funktion auf eine Zahl zwischen −1 und 1 ab, hier mit dem Tangens hyperbolicus:
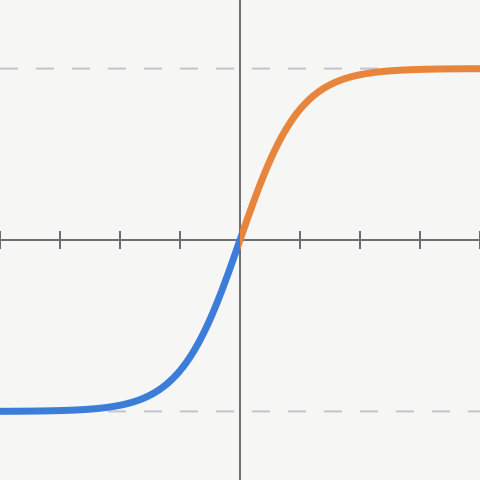
Mit dieser Funktion kann das Modell so antworten, wie es zu Beginn des Kapitels verlangt war: nahe +1 oder -1, wo es sich sicher ist, nahe 0, wo nicht. Eine solche Funktion wollen wir die Aktivierungsfunktion des Neurons nennen und seine Antwort für einen bestimmten Punkt der Ebene. Jetzt lässt sich die Antwort mit der Sorte vergleichen, die der Punkt wirklich hat:
ist der Fehler eines Punkts (englisch loss): 0, wo die Antwort genau die Sorte ist, größer, je weiter sie davon weg ist, und jede kleine Änderung eines Gewichts ändert ihn ein wenig. Der Mittelwert der Fehler aller Punkte ist der Fehler des Neurons, und das ist das Maß, das wir gesucht haben.
Der Tangens hyperbolicus ist nicht die einzige mögliche Aktivierungsfunktion. In großen Netzen nimmt man heute meist eine noch einfachere Funktion, ReLU: , also selbst, wo positiv ist, sonst 0. Ihre Steigung ist für positive immer 1, während die von tanh weit außen fast 0 wird. Was das beim Lernen ausmacht, zeigt sich im nächsten Abschnitt.
Bergab
Der Fehler unseres Neurons ist also eine Funktion der drei Werte , und . Nun wollen wir die Werte finden, für die er möglichst klein wird. Alle Kombinationen auszuprobieren geht nicht: Jeder der drei Werte kann jede Zahl sein, es gibt also unendlich viele. Selbst wenn wir für jeden Wert nur 100 Zahlen durchprobierten, wären das , eine Million Kombinationen, und für jede müssten wir den Fehler über alle Punkte ausrechnen. Für drei Werte schafft ein Rechner das noch, aber schon das Netz für XOR, das wir später bauen, hat 13 Zahlen und damit Kombinationen, und große Netze haben Millionen von Gewichten. Deshalb beginnen wir mit irgendwelchen Werten und bewegen uns von dort Schritt für Schritt in die Richtung, in der der Fehler am stärksten abnimmt, mit allen drei Werten zugleich. Welche Richtung das ist, lässt sich für jeden Wert einzeln ablesen: Wie stark ändert sich der Fehler, wenn sich der Wert ein wenig ändert? Das ist die partielle Ableitung des Fehlers nach diesem Wert, für geschrieben . Partiell heißt sie, weil sich nur dieser eine Wert ändert und die anderen festgehalten werden; das runde statt eines zeigt das an.
Der Fehler hängt nicht direkt von ab. Er hängt von der Antwort ab, die Antwort von der Summe und die Summe von . Jedes Glied dieser Kette hat eine Ableitung, die sich leicht ausrechnen lässt:
Wie stark ändert sich der Fehler, wenn sich die Antwort ändert? , die Ableitung von .
Wie stark ändert sich die Antwort, wenn sich die Summe ändert? , die Ableitung von tanh.
Wie stark ändert sich die Summe, wenn sich ändert? , denn wird mit multipliziert.
Die Kettenregel sagt: Die Ableitung der ganzen Kette ist das Produkt der Ableitungen ihrer Glieder.
Für ist der letzte Faktor , für den Bias 1. Über alle Punkte zusammengezählt und durch ihre Anzahl geteilt, sind diese partiellen Ableitungen der Gradient: die Richtung, in der der Fehler am schnellsten steigt. Ein Schritt des Gradientenabstiegs bewegt jeden der drei Werte ein wenig in die andere Richtung,
wobei die kleine Zahl die Lernrate ist.
Und wann hört man auf? Wenn der Fehler klein genug ist, oder wenn er kaum noch sinkt. Die Seiten dieses Kapitels hören auf, sobald der Fehler unter 0,02 liegt oder in hundert Schritten um weniger als 0,0001 gesunken ist. Eine solche Regel heißt Abbruchkriterium.
Probier auch die Startwerte (die Seite mit diesen Werten): Dann rührt sich das Neuron kaum, und nach hundert Schritten hält die Seite an, weil der Fehler nicht mehr sinkt. Fast alle Punkte liegen auf der falschen Seite, und zwar weit weg von der Geraden, wo tanh fast ±1 ist und kaum noch steigt. Weil der Faktor dort fast 0 ist, ist es auch der Gradient: Ein Neuron, das sich sicher irrt, lernt kaum. Man nennt das Sättigung, und deshalb beginnt man mit kleinen Gewichten.
Bessere Eingaben
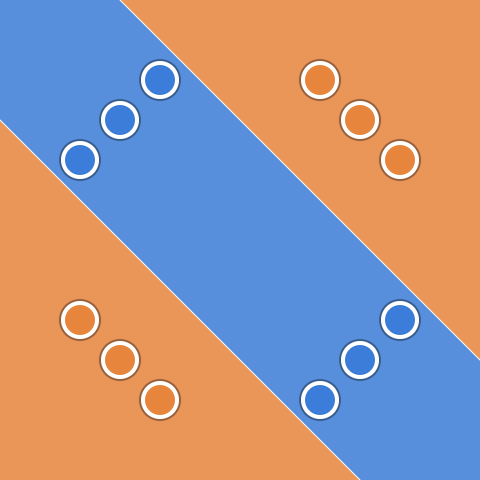
Unser Neuron teilt die Ebene durch eine Gerade. Manche Anordnungen von Punkten kann man aber nicht durch eine Gerade teilen, beispielsweise eine Scheibe oranger Punkte in einem Ring blauer: Jede Gerade hat dann Orange und Blau auf beiden Seiten.
Dem Neuron fehlt dabei nicht die Rechenkunst, sondern der richtige Blick auf die Punkte. Geben wir ihm statt und deren Quadrate als Eingaben:
Mit und etwa ist genau dort 0, wo ist, auf dem Kreis mit dem Radius 3 um den Mittelpunkt. Innen ist positiv, außen negativ:
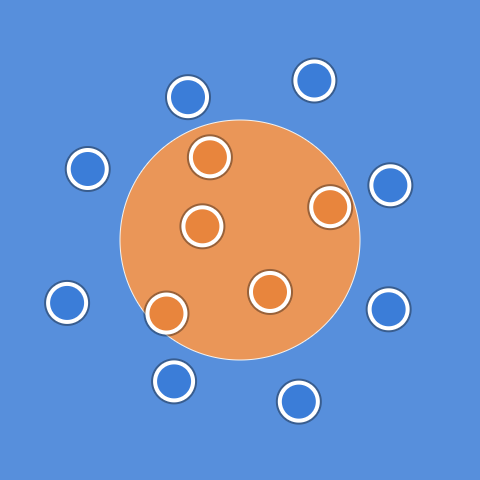
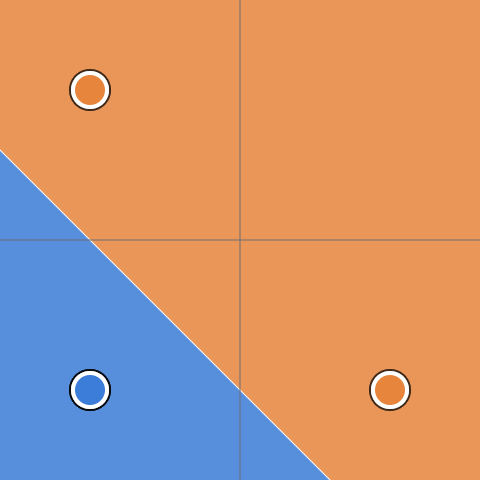
Warum kann das Neuron das plötzlich? Nennen wir seine neuen Eingaben und . Dann ist wieder eine Gerade, nur nicht in der Ebene von und , sondern in der von und . Trägt man die Punkte dort ein, liegt die Scheibe nahe am Nullpunkt und der Ring weiter draußen, und eine Gerade trennt sie:
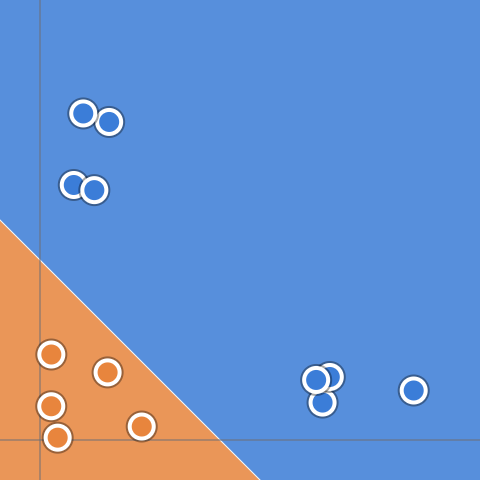
Das Neuron zieht also noch immer eine Gerade, aber in den Eingaben, die es bekommt; auf der Ebene der Punkte wird daraus ein Kreis. Auszuwählen, was ein Modell sieht, heißt Feature Engineering, und gute Eingaben können ein schweres Problem leicht machen.
Rückwärtsrechnung
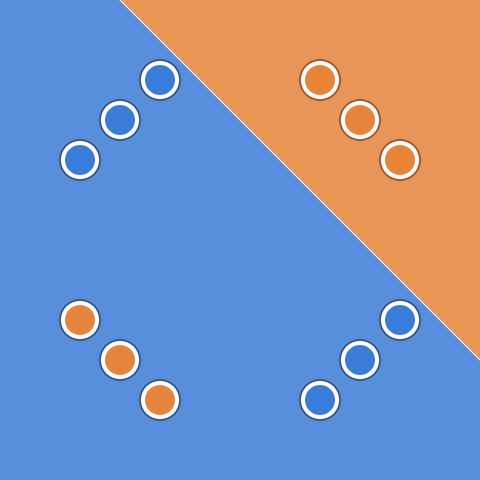
Wie lernt ein verborgenes Neuron? Seine Gewichte sind so weit vom Fehler entfernt wie nur möglich, hinter dem Ausgabeneuron. Die Kettenregel funktioniert trotzdem, mit einer Kette, die ein Glied länger ist. Der Kniff liegt in der Reihenfolge, in der sie gerechnet wird.
Zuerst wird alles vorwärts gerechnet, wie bisher: die Antwort jedes verborgenen Neurons, dann die Summe der Ausgabe und ihre Antwort . Dann rückwärts. Der Anteil des Ausgabeneurons am Fehler, der Fehler nach seiner Summe, ist das bekannte
und die Ableitungen seiner Gewichte folgen daraus wie bei einem einzelnen Neuron: für das Gewicht , das das verborgene Neuron liest. Das verborgene Neuron erreicht den Fehler über dieses Gewicht, also ist die Steigung nach seiner Antwort , und durch sein eigenes tanh wird sein Anteil am Fehler zu
Von da an sind seine Gewichte wieder die eines einzelnen Neurons: , und für seinen Bias. Der Fehler wird Schicht für Schicht rückwärts durch das Netz gereicht, der Anteil jeder Schicht aus dem Anteil der Schicht nach ihr berechnet. Das ist die Rückwärtsrechnung (englisch backpropagation), und sie ist das ganze Geheimnis, wie Netze jeder Tiefe lernen.
Die verborgenen Neuronen auf der Seite beginnen mit Absicht bei verschiedenen Gewichten. Hätten alle gleich begonnen, würden sie gleich antworten, in jedem Schritt denselben Gradienten bekommen und für immer gleich bleiben, drei Kopien einer Geraden. Deshalb beginnt ein Netz meist mit zufälligen Gewichten.
Mehr braucht ein Netz zum Lernen nicht, ganz gleich, wie viele Schichten es hat: vorwärts rechnen, den Fehler rückwärts verteilen, jedes Gewicht ein Stück gegen seinen Gradienten schieben. Wie weit das trägt, zeigt das Spielfeld, eine Seite mit einem größeren Netz als in unseren Kästen: bis zu sechs verborgene Schichten mit bis zu acht Neuronen, sieben Eingaben zur Wahl, darunter die Quadrate, und vier Anordnungen von Punkten, darunter eine Spirale. Für jedes Neuron zeigt ein kleines Quadrat, was es über der ganzen Ebene antwortet, so wie unsere Bilder für XOR.
Was es nicht gesehen hat
Ein Modell, das seine Trainingspunkte kennt, nützt noch nichts. Die Frage ist, wie gut es Punkte errät, die es nie gesehen hat. Deshalb hält das Spielfeld die Hälfte seiner Punkte als Testpunkte zurück, umrandet gezeichnet: Das Netz lernt nie aus ihnen, und der Fehler über ihnen, der Testfehler, sagt, wie gut es verallgemeinert.
Wenn die Daten verrauscht sind und das Netz groß ist, gehen die beiden Fehler auseinander. Das Netz lernt die Trainingspunkte immer besser, das Rauschen eingeschlossen, und zieht Grenzen um einzelne verirrte Punkte; der Testfehler hört auf zu fallen und steigt. Das ist Überanpassung (englisch overfitting). Ein Mittel dagegen ist Regularisierung: ein zusätzlicher Fehler für große Gewichte, für jedes Gewicht. Seine Ableitung schrumpft jedes Gewicht in jedem Schritt ein wenig, und ein Netz mit kleineren Gewichten zieht glattere Grenzen.
Das Programm des Spielfelds
Die Seite führt ein einziges Scaly-Programm aus,
field.scaly, für WebAssembly gebaut. Es sind die
Programme dieses Kapitels, erwachsen geworden: bis zu sechs
verborgene Schichten mit bis zu acht Neuronen, sieben Eingaben zur
Wahl, vier Aktivierungsfunktionen, Regularisierung, und die Rückwärtsrechnung
wie im letzten Abschnitt, nur in Schleifen über die Schichten statt
ausgeschrieben. Alles, was die Seite zeigt, hält es in einem Vektor
von Zahlen in seinem Speicher, den die Seite direkt liest, ohne
Kopie; das Bild der Antwort des Netzes über der Ebene ist ein
for über ihre 6400 Punkte, das Scaly von selbst
auf die Kerne des Rechners verteilt. Der Quelltext liegt
auf GitHub.
Alles, was dieses Kapitel von Hand hergeleitet hat, die Kettenregel durch jedes Glied und den Gradienten jedes Gewichts, kann auch ein Programm herleiten. Davon handeln die nächsten Kapitel: zuerst, wie Scaly viele Zahlen auf einmal hält, in Tensoren, dann ein Band, das die Rechnung vorwärts aufzeichnet und rückwärts abspielt, um jede Ableitung zu bekommen.